Werken met een lokaal AI model
Een kleine codewijziging laten doen zonder rekening van Anthropic of OpenAI? Draai een model lokaal. Wat we bij Quality at Speed draaien, en waarom het harnas de snelheid bepaalt.
Hoe laat ik een onschuldige kleine wijziging zoals deze doen, zonder achteraf de rekening van Anthropic, OpenAI of Microsoft te ontvangen?
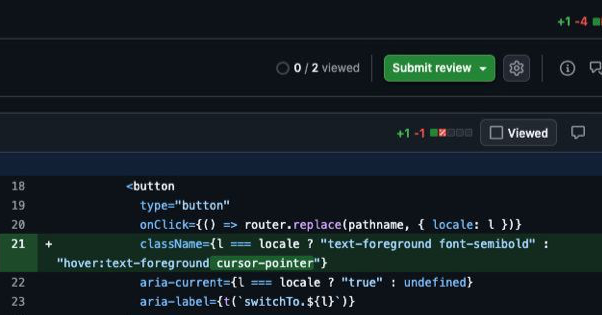
Nou, draai een model lokaal op je eigen apparatuur! Met de nadruk op een model, want topmodellen zoals Fable en GPT-6 zijn closed source en dus niet lokaal te draaien. Er zijn tegenwoordig wel veel modellen, veelal uit Azië, die vrijwel net zo goed presteren als de topmodellen van die bedrijven, mits ze zichzelf niet in de weg zitten.
Het enige wat je dan nog tegenhoudt, zijn de specificaties van je machine. Neem Qwen3.8 als voorbeeld. Dit model komt aardig in de buurt van de topmodellen op het gebied van coderen, reasoning en andere taken, maar het heeft genoeg RAM en schijfruimte nodig. Volgens Hugging Face is het ongeveer 16 GB. Dat werkt op een laptop met 32 GB werkgeheugen, mits er niet te veel andere dingen draaien.
Onze set-up
Binnen Quality at Speed gebruiken we de volgende set-up:
- mlx-serve, waarop het model draait (host)
- Oh My Pi (omp) als harnas van het model
- een Discord-integratie om ermee te kunnen praten
Tijdens het testen van verschillende modellen ben ik erachter gekomen dat tool calls niet goed doorkomen in de terminal. Daardoor liep het model vaak vast en kon het geen antwoord geven op vragen als "maak deze kleine aanpassing in dit bestand". Uiteindelijk hebben we gekozen voor het model Qwen3.8-Flash-Next-MLX-Serve-mixed-4-8bit. Dat is een communitymodel op basis van Qwen3.8. Het is wel veel groter (~80 GB), maar geeft consequent tool calls en loopt vrijwel nooit vast.
Waarom het harnas uitmaakt
De afgelopen maanden hebben we verschillende set-ups geprobeerd en bovenstaande set-up kwam als beste uit de bus. Eerder probeerden we andere harnassen om de modellen te draaien, maar die reageerden veel te traag of hadden andere problemen. Het harnas van Claude Code is heel goed in het afhandelen van permissies via de classifier van auto mode, maar het geeft ook veel context mee in elk bericht. In combinatie met cache misses (kort gezegd: tokens worden niet hergebruikt, waardoor een antwoord langer duurt) hebben we voor omp gekozen. Er zijn genoeg andere alternatieven, zoals Aider, maar dat heeft dan weer niet echt een agentic interface.
Maar waarom is het harnas omp dan sneller in de antwoorden dan Claude Code? Dat komt door de opbouw van de berichten die Claude en omp meestuurt. Claude Code stuurt elke keer een ander bericht mee met een prompt op de achtergrond, omp houdt dit bericht elke keer gelijk. Hierdoor kunnen de tokens van omp wel goed gecached worden, en die van Claude Code niet. Hierdoor kunnen de antwoorden van Claude Code tot tien minuten oplopen, terwijl bij omp het antwoord meestal binnen een paar minuten binnen komt.
Praten met BenLokaal
Na het uittesten van de juiste set-up was het tijd om het LLM een naam te geven. Wij hadden al een interne assistent draaiend op Claude, namelijk Ben. Dus was de keuze voor een variatie daarop snel gemaakt, dat werd BenLokaal.
De Discord-integratie hebben we wel door Claude (lees Ben) laten bouwen, zodat we de bridge zelf beheren. Zo kan iedereen binnen Quality at Speed praten met BenLokaal.
Elke actie van BenLokaal keuren we eerst zelf goed. Alles in het kader van veiligheid ;)
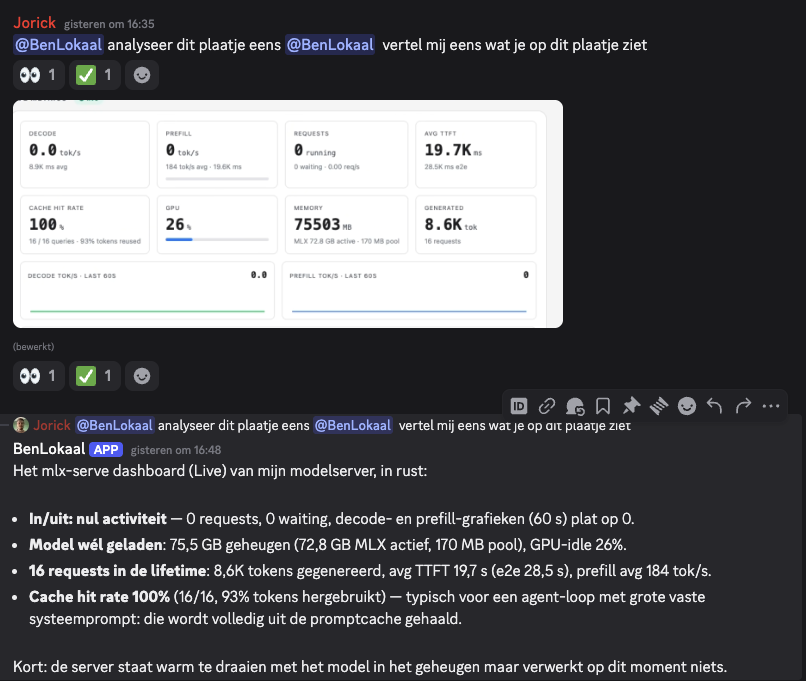
Hieronder zie je twee voorbeelden van vragen van mij en een antwoord van BenLokaal in Discord. De emojis worden door BenLokaal zelf gezet als het bericht gelezen en beantwoord is. Hierdoor is het altijd duidelijk wanneer een antwoord is gegeven en gezien.
Klaar voor sneller leveren?
Plan een vrijblijvend intro-gesprek van 30 minuten.